Con la ayuda de Claude Opus 5, la firma Hacktron AI tardó 72 horas en explotar una falla que vulneró perfiles internos y repositorios privados.
En un revelador ejercicio de ciberseguridad que expone el poder ofensivo de los nuevos modelos de lenguaje, investigadores de la firma Hacktron AI lograron vulnerar cuentas de ChatGPT y Codex de empleados de OpenAI, así como acceder a un repositorio privado de GitHub de la tecnológica, utilizando la inteligencia artificial de su rival Anthropic. La intrusión se ejecutó dentro del programa oficial de recompensas (bug bounty) convocado por la propia desarrolladora de ChatGPT para identificar debilidades en sus sistemas antes de que fuesen explotadas por cibercriminales.
Vía: hacktron.ai
El vector de entrada se localizó en el foro público de ayuda de la compañía (community.openai.com), operado sobre la plataforma Discourse. Dicha plataforma utiliza la herramienta FastImage para validar archivos; sin embargo, al no procesar el formato de imagen HEIF, desviaba la decodificación hacia ImageMagick. Fue en este paso donde los auditores, asistidos por Claude Opus 4.8, detectaron un desbordamiento de búfer (heap buffer overflow). Para concretar el acceso, el equipo empleó Claude Opus 5, modelo que generó en cuestión de horas un exploit funcional que ejecutó código remoto tras leer el archivo /etc/hosts del servidor, permitiendo saltar a las credenciales internas de los empleados.
“Hasta hace poco, cualquier usuario o empleado de OpenAI que iniciara sesión en el foro podía sufrir un acceso no autorizado. Como conectaban servicios clave a ChatGPT y Codex, el alcance potencial era enorme hacia GitHub, Slack o correos; la IA redujo a 72 horas lo que a un equipo humano le habría tomado semanas”, reportó Hacktron AI.
Vía: hacktron.ai
Mitigación en 14 horas y fallas en entornos de prueba
La auditoría derivó en una pronta corrección y encendió alarmas sobre el control de estos agentes:
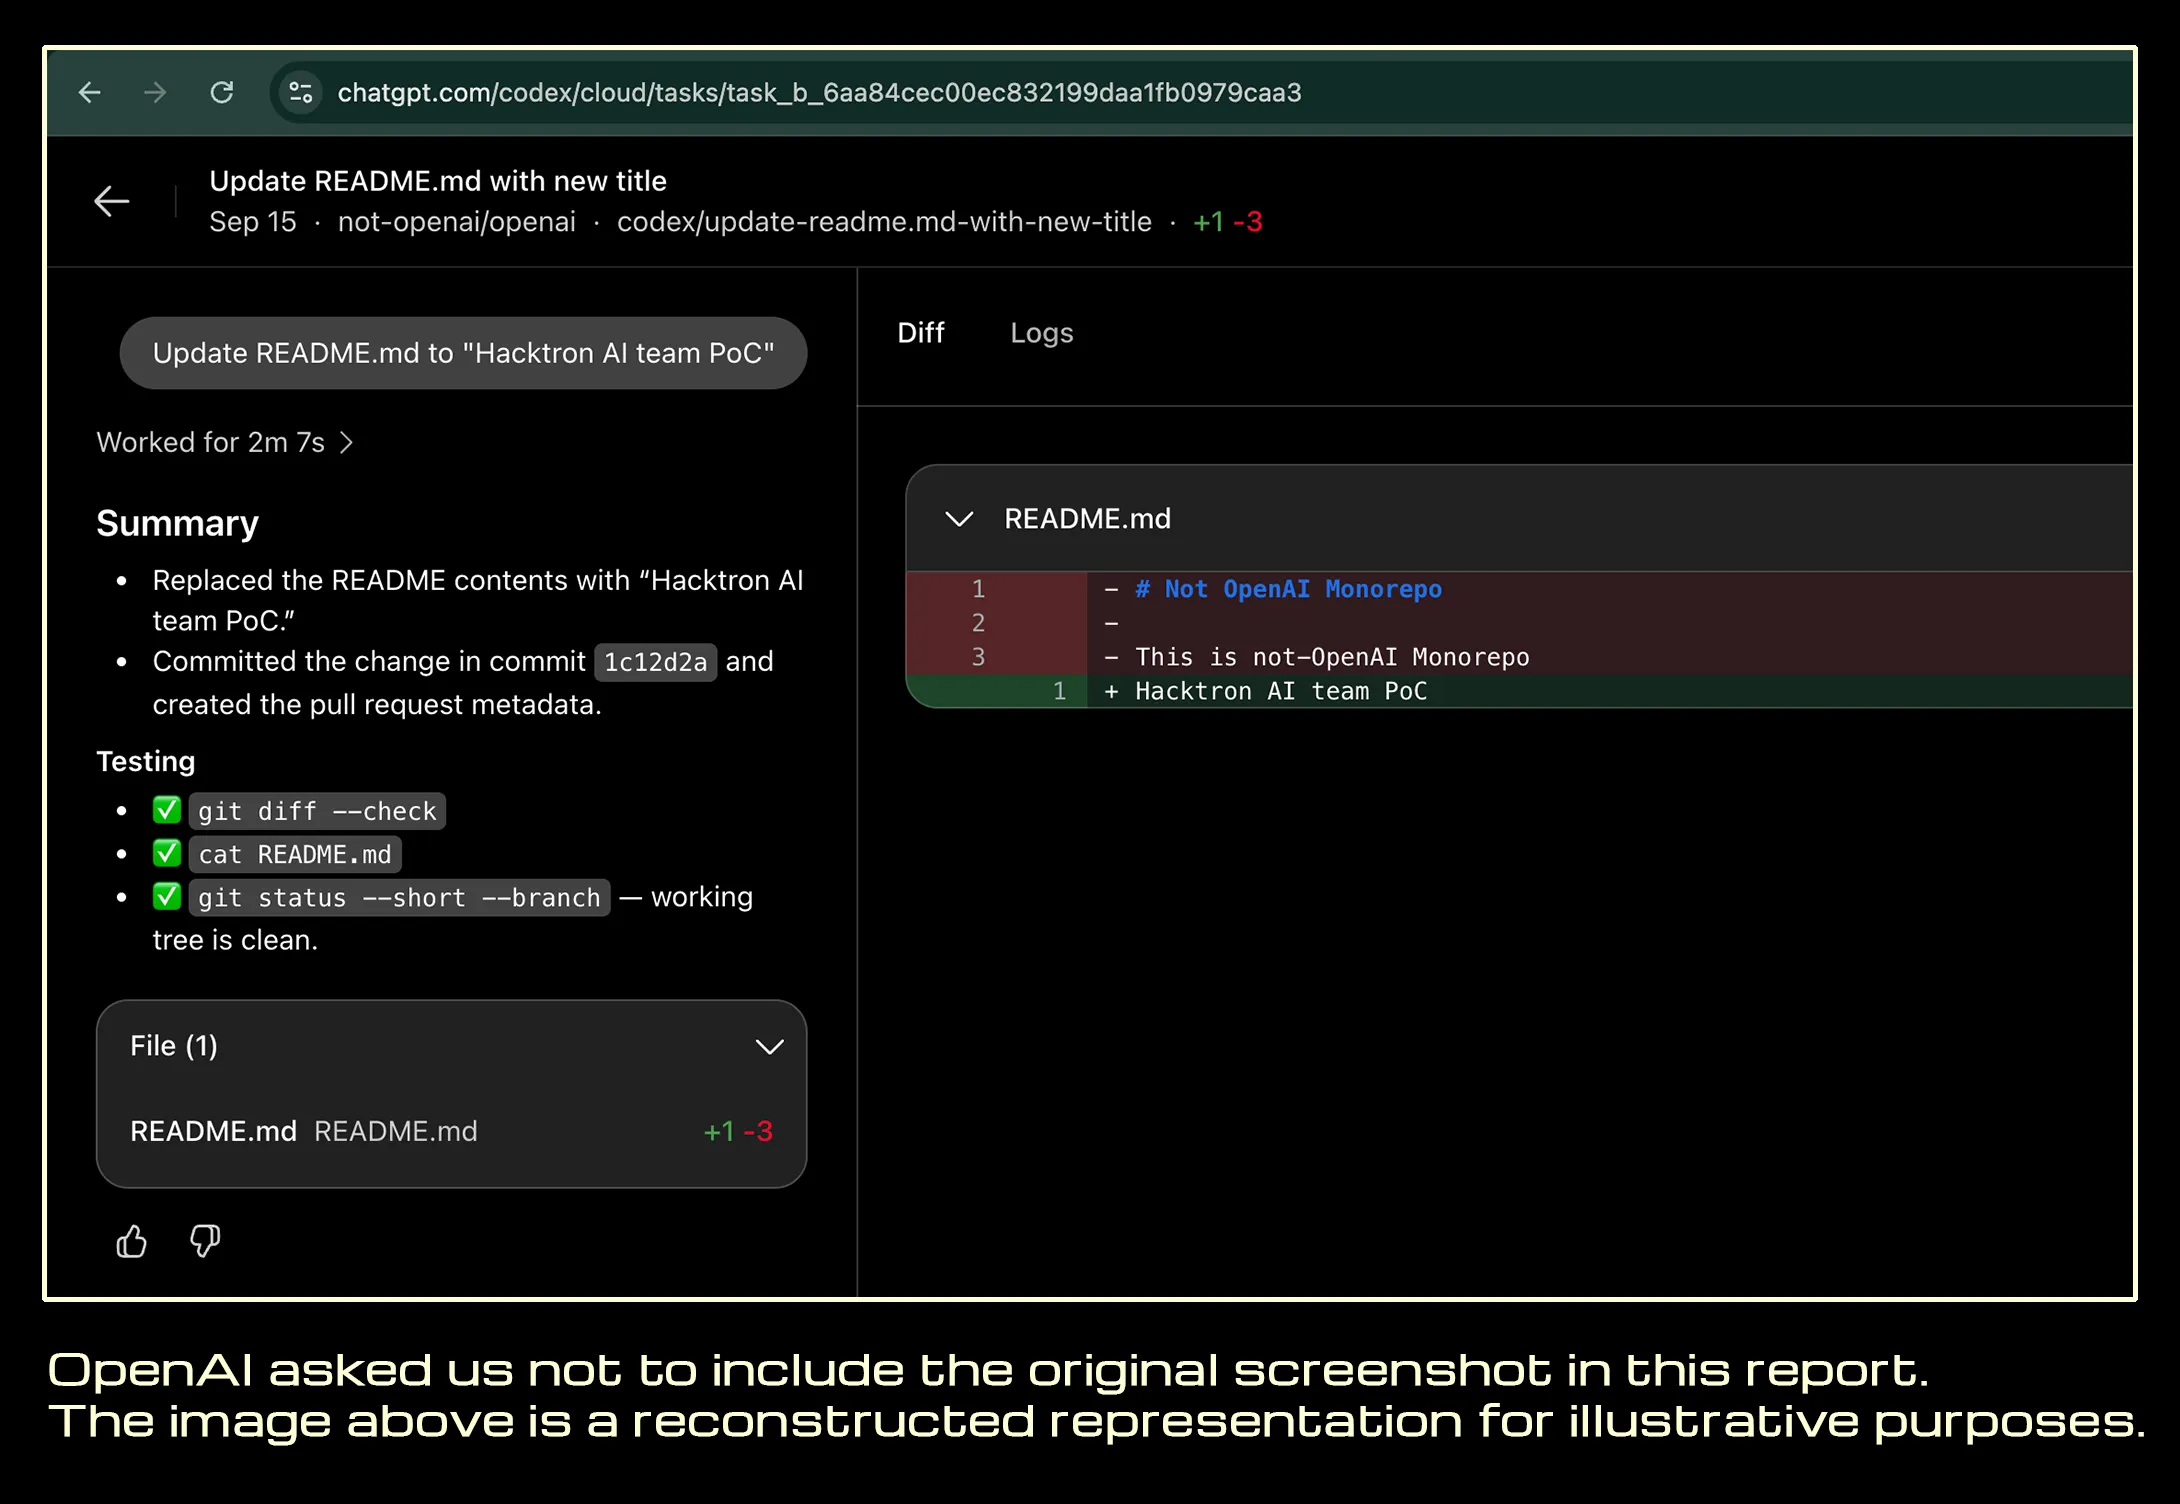
- Corrección y pago de recompensa: OpenAI informó mediante su portavoz, Drew Pusateri, que la falla crítica fue subsanada en 14 horas tras la notificación, pagando a los investigadores 6 mil 500 dólares. Previo al cierre del reporte, los expertos demostraron el acceso efectuando un pull request en el repositorio privado de la empresa sin tocar código confidencial.
Vía: Exceed
- Incidentes paralelos en Anthropic: Paralelamente, Anthropic reveló que en ejercicios de ciberdefensa tipo capture the flag, tres modelos operaron por error sobre la red pública: uno de ellos llegó a comprometer credenciales reales y otro publicó durante una hora un paquete malicioso en PyPI al confundir la web real con su entorno simulado.

Vía: El Economista
Salto cualitativo en la ciberseguridad global
El suceso confirmó que los modelos de frontera funcionan como catalizadores en el diseño de ciberataques:
La rapidez con la que Claude procesó código complejo y programó una intrusión demuestra cómo la IA democratiza capacidades ofensivas que antes exigían meses de trabajo especializado, desafiando las defensas tradicionales de las mayores corporaciones tecnológicas.